Blue-Green Deployment: como reduzir riscos durante uma publicação
Topicos: Conceitos de Engenharia de Software
Publicado em 24/10/2026 por AdminPublicar uma nova versão de uma aplicação em produção é uma das atividades que mais exigem atenção de uma equipe de desenvolvimento.
Mesmo quando todos os testes passam, problemas podem aparecer depois do deploy. Uma alteração pode introduzir erros inesperados, afetar integrações, aumentar o tempo de resposta ou provocar falhas em operações importantes.
Em aplicações críticas, uma publicação mal-sucedida pode comprometer a experiência dos usuários e gerar indisponibilidade.
Uma estratégia que ajuda a reduzir esses riscos é o Blue-Green Deployment.
A ideia é manter dois ambientes de aplicação: um que atende ao tráfego atual e outro que recebe a nova versão. Depois de validar o ambiente atualizado, o tráfego é direcionado para ele.
Se surgir algum problema, a equipe pode redirecionar o tráfego para o ambiente anterior, desde que ele continue operacional e compatível com o estado dos dados.
Neste artigo, vamos entender como funciona essa estratégia, como implementá-la em aplicações .NET e quais cuidados são necessários para utilizá-la em produção.
1. O que é Blue-Green Deployment?
Blue-Green Deployment é uma estratégia de implantação que utiliza dois ambientes distintos para reduzir o risco de publicar uma nova versão de uma aplicação.
Tradicionalmente, os ambientes são chamados de Blue e Green.
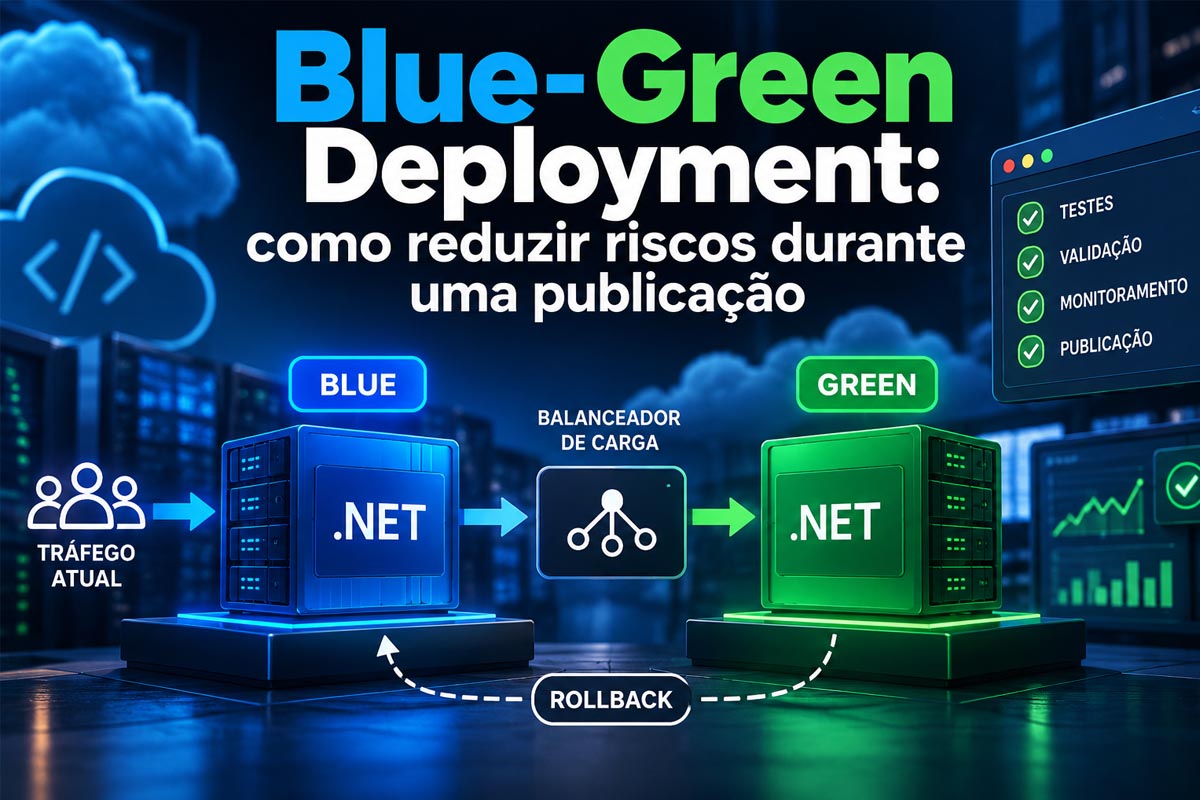
O ambiente Blue representa a versão que está atendendo aos usuários. O ambiente Green recebe a nova versão e passa por verificações antes de assumir o tráfego de produção.
Depois da validação, a equipe altera o roteamento para que as requisições sejam direcionadas ao ambiente Green.
A arquitetura simplificada funciona assim:
-
A versão atual está executando no ambiente Blue.
-
A nova versão é implantada no ambiente Green.
-
A equipe executa testes e verificações de saúde.
-
O tráfego é direcionado para o ambiente Green.
-
A equipe monitora o comportamento da nova versão.
-
Se houver um problema, o tráfego pode voltar para o Blue.
O benefício principal é separar a implantação da nova versão da mudança que faz essa versão atender aos usuários.
Em vez de substituir diretamente a aplicação em execução, a equipe prepara um ambiente alternativo e realiza a troca de tráfego de maneira controlada.
2. Qual é a diferença entre Blue-Green e um deploy tradicional?
Em um deploy tradicional, a atualização pode substituir os arquivos ou as instâncias que atendem à aplicação.
Dependendo da infraestrutura e do procedimento utilizado, isso pode provocar interrupções, indisponibilidade temporária ou um período em que parte das instâncias executa uma versão diferente da outra.
O Blue-Green Deployment procura evitar essa substituição direta.
| Característica | Deploy tradicional | Blue-Green Deployment |
|---|---|---|
| Ambientes de aplicação | Pode utilizar o mesmo ambiente durante a atualização | Mantém dois ambientes durante a transição |
| Validação prévia | Depende da estratégia adotada | Permite validar o ambiente alternativo antes da troca |
| Mudança de tráfego | Pode ocorrer durante a atualização | Ocorre após a preparação do novo ambiente |
| Rollback | Depende do processo de recuperação | Pode ser feito redirecionando o tráfego ao ambiente anterior |
| Consumo de recursos | Pode ser menor | Pode ser maior enquanto os dois ambientes coexistem |
| Complexidade operacional | Varia conforme o processo | Exige controle dos ambientes e do roteamento |
É importante destacar que um deploy tradicional não significa necessariamente indisponibilidade. Estratégias de atualização gradual também podem oferecer continuidade do serviço.
A principal diferença é que o Blue-Green mantém um ambiente alternativo preparado para receber o tráfego.
3. Como funciona o roteamento entre os ambientes?
Para que a estratégia funcione, é necessário controlar como as requisições chegam à aplicação.
Esse controle pode ser implementado por meio de um balanceador de carga, um proxy reverso, um mecanismo de roteamento ou uma funcionalidade específica da plataforma de hospedagem.
Considere uma aplicação ASP.NET Core hospedada em dois conjuntos de instâncias.
O ambiente Blue executa a versão 1.0, enquanto o Green executa a versão 1.1.
Inicialmente, o tráfego é direcionado para o Blue.
Quando a versão 1.1 estiver implantada e validada, a configuração de roteamento será alterada para direcionar as requisições ao Green.
O processo pode ser representado da seguinte forma:
Antes da publicação
Usuários → Balanceador de carga → Blue (versão 1.0)
Durante a preparação
Usuários → Balanceador de carga → Blue (versão 1.0)
Nova versão → Green (versão 1.1) → Testes de validação
Depois da troca
Usuários → Balanceador de carga → Green (versão 1.1)
Em caso de falha
Usuários → Balanceador de carga → Blue (versão 1.0)
A velocidade da troca depende da infraestrutura utilizada. A mudança de roteamento não garante, por si só, uma transição instantânea para todas as requisições ou conexões existentes.
Sessões persistentes, conexões de longa duração, caches e processos em andamento precisam ser considerados no planejamento.
4. Como implementar Blue-Green Deployment em uma aplicação .NET?
Vamos considerar uma API construída com ASP.NET Core.
A aplicação utiliza uma imagem Docker e é executada em uma infraestrutura capaz de manter duas versões em paralelo.
O objetivo é publicar uma versão nova sem substituir imediatamente aquela que está atendendo aos usuários.
Etapa 1: preparar a aplicação
Antes de pensar no deploy, é importante que a aplicação tenha um processo de construção reproduzível.
O pipeline deve gerar um artefato ou uma imagem identificável, que possa ser promovida entre ambientes sem precisar ser reconstruída de maneira diferente para cada etapa.
Uma abordagem comum é utilizar uma imagem Docker.
Um Dockerfile simplificado para uma aplicação ASP.NET Core pode seguir esta estrutura:
FROM mcr.microsoft.com/dotnet/aspnet:10.0 AS base
WORKDIR /app
EXPOSE 8080

FROM mcr.microsoft.com/dotnet/sdk:10.0 AS build
WORKDIR /src

COPY ["MinhaApi/MinhaApi.csproj", "MinhaApi/"]
RUN dotnet restore "MinhaApi/MinhaApi.csproj"

COPY . .
WORKDIR "/src/MinhaApi"
RUN dotnet publish "MinhaApi.csproj" \
    -c Release \
    -o /app/publish

FROM base AS final
WORKDIR /app
COPY --from=build /app/publish .
ENTRYPOINT ["dotnet", "MinhaApi.dll"]
Esse exemplo pressupõe uma aplicação compatível com .NET 10 e uma estrutura de diretórios correspondente aos caminhos utilizados.
O nome do projeto, a versão da imagem e as configurações de portas devem ser ajustados conforme a solução real.
Em produção, também é importante utilizar imagens oficiais atualizadas e avaliar a fixação de versões ou digests para garantir a rastreabilidade dos artefatos.
Etapa 2: publicar no ambiente alternativo
Depois de construir e validar a imagem, o pipeline deve implantá-la no ambiente Green.
O ambiente Blue continua atendendo aos usuários enquanto a nova versão é preparada.
Nesse momento, a equipe pode executar testes de fumaça, verificações de conectividade e testes de integração contra o ambiente alternativo.
É importante validar não apenas se a aplicação inicia, mas também se consegue acessar os serviços necessários.
Por exemplo:
-
O banco de dados está acessível?
-
As dependências externas respondem?
-
A autenticação funciona?
-
A aplicação consegue publicar e consumir mensagens?
-
Os endpoints principais retornam os resultados esperados?
As verificações devem refletir os riscos reais da aplicação.
Etapa 3: configurar verificações de saúde
Uma aplicação ASP.NET Core pode disponibilizar endpoints de health check para permitir que a infraestrutura verifique seu estado.
O ASP.NET Core oferece suporte a health checks por meio do pacote Microsoft.Extensions.Diagnostics.HealthChecks.
Um exemplo simplificado é:
var builder = WebApplication.CreateBuilder(args);

builder.Services.AddHealthChecks();

var app = builder.Build();

app.MapHealthChecks("/health");

app.MapGet("/", () => "Minha API está funcionando!");

app.Run();
Esse exemplo disponibiliza um endpoint básico de saúde.
Entretanto, ele não comprova que o banco de dados, a fila de mensagens ou todas as integrações estejam funcionando corretamente.
Para isso, é necessário registrar verificações adicionais apropriadas às dependências da aplicação.
Também vale separar verificações de disponibilidade básica de verificações de prontidão para receber tráfego.
Um endpoint de saúde excessivamente abrangente pode gerar falsos negativos quando uma dependência secundária apresenta problemas. Por outro lado, um endpoint simples demais pode indicar que tudo está funcionando mesmo quando uma operação essencial está indisponível.
Etapa 4: executar testes antes da troca
Com o Green preparado, o pipeline deve executar as verificações necessárias antes de direcionar o tráfego.
Dependendo do projeto, isso pode incluir:
-
Testes automatizados.
-
Testes de fumaça.
-
Validação de autenticação e autorização.
-
Testes de integração.
-
Verificação de conectividade com dependências.
-
Validação de configurações.
-
Testes de desempenho direcionados.
-
Verificação de métricas e logs.
Quando possível, a equipe pode testar a nova versão por uma rota interna que não seja utilizada pelos usuários finais.
Essa abordagem permite encontrar problemas sem expor a versão recém-publicada ao tráfego normal.
Etapa 5: trocar o tráfego
Depois da aprovação, o mecanismo de roteamento passa a direcionar as requisições para o ambiente Green.
A implementação concreta depende da plataforma.
Pode ser uma alteração de configuração em um balanceador de carga, uma atualização de roteamento ou a utilização de recursos próprios do serviço de hospedagem.
A troca precisa ser automatizada e auditável.
Também é recomendável definir critérios objetivos para a aprovação, como a aprovação dos testes de fumaça e a ausência de erros críticos durante a validação.
Etapa 6: monitorar a nova versão
A publicação não termina quando o tráfego é alterado.
É necessário observar o comportamento da aplicação depois da troca.
Entre os indicadores relevantes estão:
-
Taxa de erros HTTP.
-
Latência das requisições.
-
Uso de CPU e memória.
-
Falhas de autenticação.
-
Erros de conexão com o banco de dados.
-
Falhas no processamento de mensagens.
-
Exceções registradas pela aplicação.
Se os indicadores ultrapassarem os limites definidos, o processo de implantação pode interromper a promoção ou acionar o procedimento de recuperação.
O monitoramento deve ser integrado à estratégia de deploy, e não tratado como uma atividade opcional.
5. Como fazer Blue-Green Deployment no Azure?
O Azure oferece diferentes opções para implementar essa estratégia.
Uma delas é o Azure App Service, que possui slots de implantação em planos compatíveis.
Os slots permitem manter versões distintas da aplicação em ambientes separados e realizar operações de troca entre eles.
Uma configuração típica pode utilizar o slot de produção e um slot de homologação ou staging.
O processo geral é:
-
Implantar a nova versão no slot de staging.
-
Executar testes e verificações de saúde.
-
Validar configurações e dependências.
-
Realizar a troca entre os slots.
-
Monitorar a aplicação após a publicação.
-
Executar o procedimento de recuperação caso necessário.
É necessário verificar os recursos disponíveis no plano contratado e compreender o comportamento das configurações durante a troca.
Configurações específicas podem ser definidas como configurações de slot, evitando que determinados valores sejam trocados juntamente com o conteúdo da aplicação.
Também é importante considerar que o estado de processos em execução, sessões e conexões pode ser afetado pela operação.
A documentação oficial do Azure App Service detalha o funcionamento dos slots e suas limitações.
6. Como fazer Blue-Green Deployment na AWS?
Na AWS, a implementação depende do serviço utilizado para hospedar a aplicação.
Uma alternativa é o AWS Elastic Beanstalk, que oferece uma estratégia de implantação chamada Blue/Green, baseada na criação de um ambiente separado e na troca de referências de tráfego entre ambientes.
Outra possibilidade é construir uma estratégia própria com serviços de computação, containers e balanceamento de carga.
Por exemplo, uma aplicação executada em containers pode manter dois conjuntos de serviços, cada um associado a uma versão diferente.
A equipe prepara a nova versão, valida o ambiente e modifica o roteamento para direcionar as requisições ao conjunto atualizado.
Em uma arquitetura com ECS, o desenho exato depende da configuração dos serviços, dos target groups e das regras de roteamento.
É necessário planejar como as tarefas antigas serão encerradas, como as conexões serão tratadas e como o ambiente anterior permanecerá disponível para recuperação.
Não existe um procedimento universal que sirva para todas as arquiteturas AWS. A implementação deve seguir as características do serviço escolhido.
7. O maior risco: alterações no banco de dados
Um dos erros mais comuns ao implementar Blue-Green Deployment é presumir que o rollback da aplicação também reverte automaticamente o banco de dados.
Isso não acontece.
Os dois ambientes podem utilizar o mesmo banco de dados. Quando a nova versão modifica dados ou altera o esquema, a versão anterior pode deixar de funcionar corretamente.
Imagine uma aplicação que utiliza a tabela Clientes.
Na versão atual, existe uma coluna chamada Nome. A nova versão precisa dividir essa informação em duas colunas: PrimeiroNome e Sobrenome.
Se a equipe remover imediatamente a coluna antiga, a versão anterior pode falhar caso seja necessário retornar ao Blue.
Uma estratégia mais segura é realizar alterações compatíveis em etapas.
Uma abordagem conhecida como expand-and-contract pode seguir este fluxo:
-
Adicionar as novas colunas sem remover as antigas.
-
Publicar uma versão compatível com a estrutura anterior e a nova.
-
Migrar os dados de maneira controlada.
-
Atualizar a aplicação para utilizar a nova estrutura.
-
Confirmar que a versão antiga não precisa mais dos campos anteriores.
-
Remover os componentes obsoletos em uma publicação posterior.
A sequência exata depende do modelo de dados e das exigências de consistência.
Em sistemas com grande volume de dados, as migrações podem precisar ser executadas em etapas, com atenção aos bloqueios, ao tempo de execução e à carga do banco.
O mesmo cuidado vale para mensagens, eventos e integrações externas: depois que a nova versão altera o estado de um sistema externo, redirecionar o tráfego para a versão anterior pode não desfazer os efeitos produzidos.
8. Blue-Green Deployment é a mesma coisa que Canary Deployment?
Não.
Embora as duas estratégias busquem reduzir os riscos de uma publicação, elas controlam a exposição à nova versão de maneiras diferentes.
No Blue-Green Deployment, a equipe normalmente prepara o ambiente alternativo e realiza uma troca de tráfego para a nova versão.
No Canary Deployment, a nova versão é disponibilizada inicialmente para uma parcela do tráfego ou dos usuários. A exposição pode aumentar gradualmente conforme os indicadores observados.
| Aspecto | Blue-Green | Canary |
|---|---|---|
| Estratégia principal | Preparar dois ambientes e trocar o tráfego | Liberar a nova versão gradualmente |
| Exposição inicial | Pode ocorrer após uma troca ampla | Começa com uma parcela controlada |
| Monitoramento | Antes e depois da troca | Durante cada etapa de expansão |
| Infraestrutura | Pode exigir dois ambientes completos | Depende da capacidade de executar e rotear para múltiplas versões |
| Recuperação | Redirecionamento para o ambiente anterior, quando seguro | Redução ou remoção gradual do tráfego da nova versão |
As duas abordagens podem ser combinadas.
Por exemplo, uma equipe pode preparar o ambiente Green e, em vez de direcionar imediatamente todo o tráfego para ele, liberar a nova versão de maneira gradual.
Isso exige suporte adequado de roteamento e observabilidade.
9. Quais são as desvantagens do Blue-Green Deployment?
Apesar das vantagens, a estratégia não é gratuita nem elimina todos os riscos.
Maior consumo de recursos
Manter duas versões executando simultaneamente pode aumentar o consumo de computação e outros recursos.
Esse custo pode ser temporário, durante a publicação, ou permanente, caso a arquitetura mantenha os dois ambientes prontos para uso.
Complexidade de configuração
A equipe precisa administrar ambientes, configurações, segredos, redes, roteamento e políticas de acesso.
Diferenças acidentais entre Blue e Green podem provocar falhas difíceis de reproduzir.
O uso de infraestrutura como código ajuda a manter os ambientes consistentes.
Estado compartilhado
Sessões armazenadas localmente, caches, arquivos locais e processos em andamento podem complicar a transição.
Sempre que possível, o estado que precisa sobreviver à troca de versões deve ser tratado por mecanismos adequados, como armazenamento persistente, bancos de dados ou caches compartilhados.
Rollback nem sempre é seguro
Se a nova versão modificar dados de maneira incompatível, retornar à aplicação anterior pode provocar erros ou perda de consistência.
Por isso, rollback precisa ser testado como parte do processo de implantação.
Não elimina falhas de infraestrutura
Se os dois ambientes dependem do mesmo banco de dados e esse banco ficar indisponível, a troca de tráfego não resolverá o problema.
A estratégia reduz determinados riscos de publicação, mas não substitui uma arquitetura de alta disponibilidade e recuperação de desastres.
10. Checklist para implementar Blue-Green Deployment
Antes de adotar essa estratégia em produção, vale verificar os seguintes pontos:
-
Os dois ambientes podem ser provisionados de maneira consistente.
-
O pipeline identifica claramente a versão implantada em cada ambiente.
-
A nova versão é validada antes de receber tráfego.
-
Existem verificações de saúde adequadas.
-
O mecanismo de roteamento foi testado.
-
As configurações específicas de cada ambiente estão corretas.
-
Os segredos não são compartilhados de maneira insegura.
-
As alterações no banco de dados são compatíveis com a versão anterior.
-
O procedimento de rollback foi testado.
-
As métricas e os logs permitem identificar problemas após a troca.
-
O custo de manter dois ambientes foi avaliado.
-
Existe um responsável pelo acompanhamento da publicação.
O checklist deve ser adaptado à criticidade e à arquitetura de cada aplicação.
Conclusão
Blue-Green Deployment é uma estratégia valiosa para equipes que precisam reduzir os riscos de implantação e controlar melhor a transição entre versões de uma aplicação.
Ao preparar um ambiente alternativo, validar a nova versão e controlar a mudança de tráfego, a equipe ganha mais previsibilidade e pode simplificar a recuperação de determinadas falhas.
No entanto, a estratégia exige atenção especial às alterações no banco de dados, ao estado compartilhado, às integrações externas e à consistência entre ambientes.
Para aplicações .NET hospedadas na AWS ou no Azure, a implementação pode aproveitar recursos gerenciados da plataforma ou utilizar componentes de infraestrutura configurados pela própria equipe.
O mais importante é tratar o deploy como um processo de engenharia: automatizado, observável, testável e acompanhado por um plano de recuperação.
Uma publicação segura não depende apenas de conseguir colocar o código novo em produção. Depende também de saber identificar problemas rapidamente e recuperar o serviço sem comprometer os dados.